Bastidores· Arrumando a casa · parte 15
Uma conta para organizar erros, métricas e IA dos meus produtos.
O padrão para gerenciar erros, métricas de produto e chaves de inteligência artificial em múltiplos projetos usando uma única conta central e regras claras.

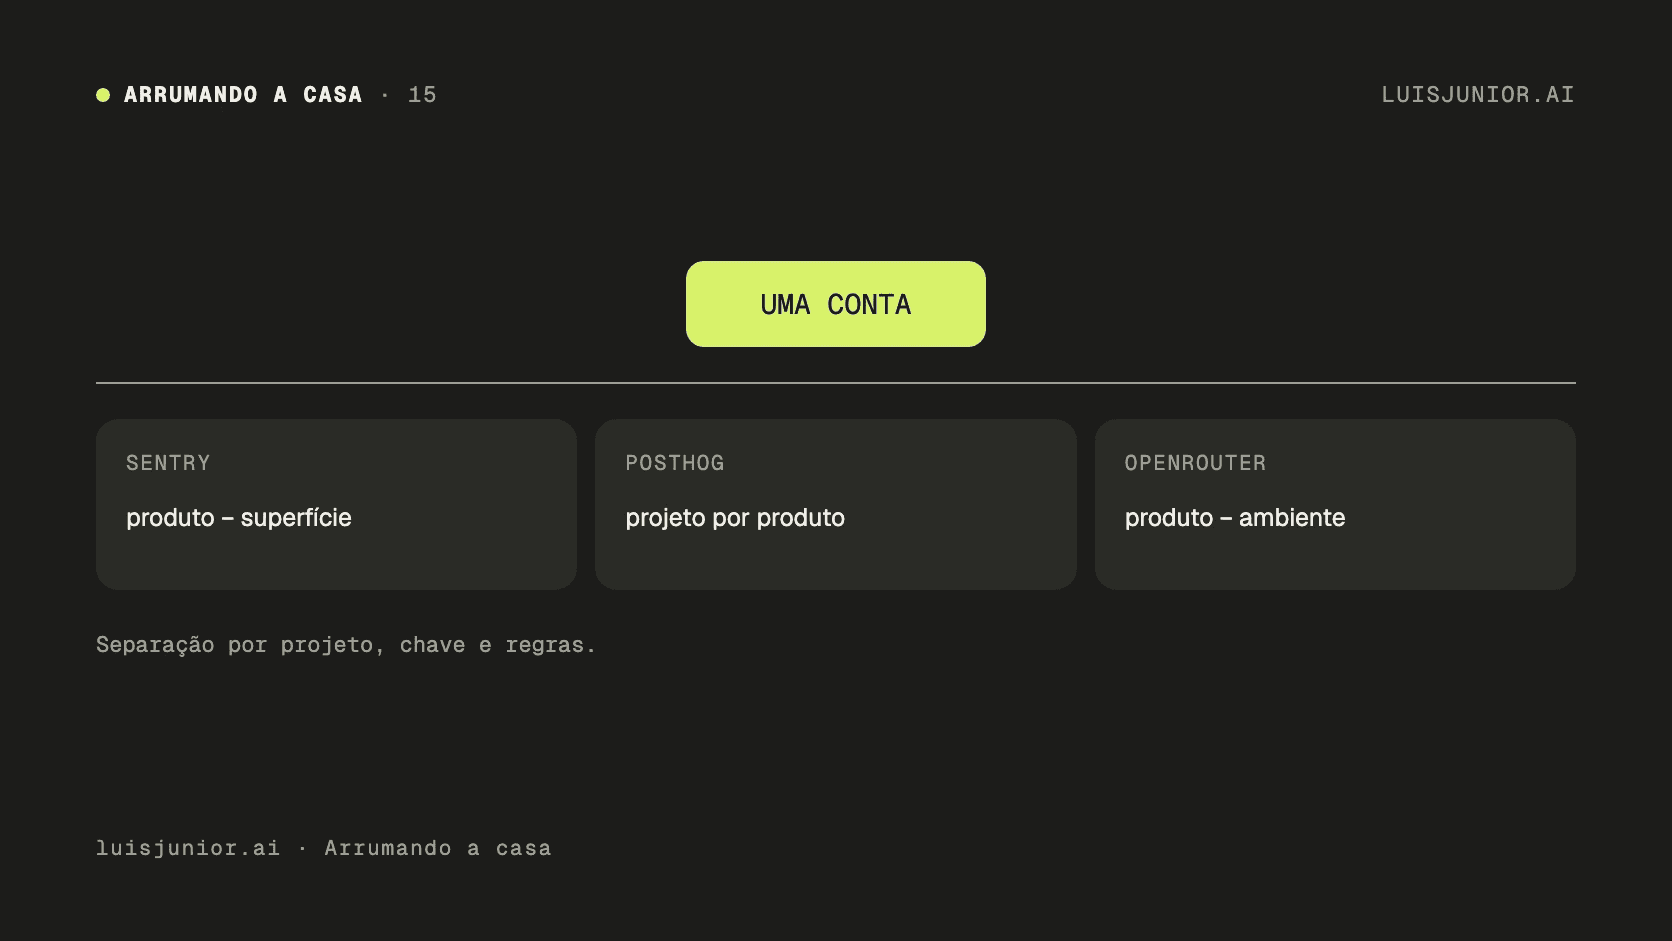
Uma conta por serviço basta para organizar erros, métricas e chaves de IA dos meus produtos. Quando você constrói vários sistemas sozinho, a tentação inicial é criar contas e organizações isoladas para cada lançamento. Esse caminho parece organizado no primeiro dia, mas gera dispersão de acessos, configurações repetidas e perda de visão global.
Como todos os produtos pertencem à mesma operação, uma única conta basta para cada serviço. A separação do que pertence a cada iniciativa não exige cadastros separados: ela fica clara na estrutura dos projetos, nas regras de nomenclatura e nas políticas de proteção.
Uma organização central simplifica a governança de vários produtos
Gerenciar uma conta para cada ideia cria atrito diário. Toda vez que um erro surge ou uma métrica precisa ser conferida, você precisa alternar acessos e verificar permissões diferentes. Além disso, configurações essenciais de segurança acabam esquecidas em ambientes abandonados.
Ao centralizar a governança, mantenho uma organização no Sentry, uma no PostHog e um espaço de trabalho no provedor de modelos. Os créditos e os recursos contratados servem a toda a operação. A divisão do trabalho é transferida para identificadores padronizados e convenções seguidas à risca em cada repositório.
Com esse padrão, um projeto novo começa com convenções de nome, ambiente e privacidade definidas.
O padrão no Sentry separa superfícies e centraliza os alertas
No Sentry, a estrutura foi padronizada com um projeto dedicado para cada superfície do produto. Adoto a nomenclatura composta pelo identificador do produto e a superfície correspondente, como no Garfim com os projetos garfim-api e garfim-native.
Ambientes de teste e produção convivem no mesmo projeto. O SDK do Sentry envia a identificação do ambiente em cada evento, permitindo filtrar as ocorrências nas consultas sem duplicar a estrutura da plataforma. Cada projeto é vinculado ao respectivo repositório de código por meio da integração oficial do GitHub.
Os alertas seguem o modelo padrão de problemas de alta prioridade, notificando por e-mail quando um erro inédito surge, quando uma falha antiga volta ou quando a frequência dispara. Para o envio de mapas de código, cada produto recebe um token exclusivo com a data de criação no nome. Esse identificador fica registrado apenas nas ferramentas de automação, nunca em arquivos versionados. Ao renovar a credencial, um novo token datado substitui o anterior, que é revogado.
O PostHog isola dados de análise respeitando a privacidade
A análise de produto no PostHog segue o mesmo princípio de organização única. Em vez de pulverizar cadastros, crio um projeto individual para cada iniciativa comercial.
Os testes internos e o uso real também compartilham o mesmo espaço. A distinção entre eles ocorre pela origem da requisição e por filtros de contas de teste ativados por padrão em todos os relatórios. Isso impede que acessos de verificação distorçam os gráficos de retenção e navegação.
No quesito privacidade, uma diretriz rigorosa orienta todas as configurações. A opção de descartar o endereço de IP dos visitantes permanece ativada em cada projeto desde a criação. As gravações de sessão só são autorizadas a capturar telas nos domínios oficiais do produto e ficam armazenadas pelo prazo máximo de 30 dias. O fuso horário de cada painel é ajustado conforme o mercado prioritário atendido pelo serviço.
As chaves de inteligência artificial precisam de limite diário e sem expiração
Para chamadas de modelos no OpenRouter, utilizo uma conta única com um saldo centralizado compartilhado. A segregação das credenciais segue um formato rigoroso: cada chave recebe o nome composto pelo produto e o ambiente, em letras minúsculas, diferenciando os contextos de homologação e produção. O desenvolvimento local usa respostas simuladas; scripts e avaliações que precisam do modelo real usam a chave de staging.
A primeira regra das chaves é nunca definir prazo de validade. Uma credencial com data de expiração interrompe as funcionalidades inteligentes do aplicativo sem aviso prévio, muitas vezes fora do horário de trabalho. A troca de credenciais deve ser uma decisão manual e controlada, executada caso haja suspeita de vazamento.
A segunda regra é o limite diário por chave, que reinicia à meia-noite no horário UTC. Esse teto de gasto fica acima do consumo habitual e funciona como trava de segurança: caso ocorra um laço de repetição acidental ou uma credencial fique exposta, a operação dos outros produtos continua protegida. Se a demanda legítima cresce, o limite daquele produto é ajustado conscientemente.
A privacidade dos dados fica travada no código e no provedor
A proteção das informações dos usuários não depende apenas de uma configuração genérica no painel. A regra de dados de cada produto fica no código, em cada chamada. Os produtos podem ter exigências de privacidade diferentes.
Quando o produto promete retenção zero e seus modelos têm endpoints compatíveis, as chaves recebem um guardrail com o nome do produto. Essa configuração exige a mesma regra como segunda trava.
A gravação de registros de entrada e saída fica totalmente desligada no espaço de trabalho. Assim, o workspace não grava prompts no OpenRouter. Uma credencial recém-gerada é exibida uma única vez, salva no gerenciador seguro e transferida como segredo da aplicação.
Esses critérios transformaram a infraestrutura em um sistema previsível e fácil de manter. Para entender como essa mesma lógica de padronização orienta a infraestrutura de rede, leia sobre o padrão de domínios na Cloudflare.