Inteligência artificial· Como trabalho com IA · parte 6
Troquei velocidade por uma auditora que confere cada frase.
Dois recursos que escrevem em nome do usuário ganharam agente, guarda em código e auditora frase a frase. O acerto subiu e a espera também.

Num produto que ainda não apresentei aqui, dois recursos escrevem textos curtos em nome do usuário, a partir dos documentos que ele mesmo enviou, e esses textos vão direto para outra pessoa. Um deles produz uma mensagem e o outro produz uma resposta a uma pergunta de formulário. Uma frase inventada ali fala pelo usuário algo que ele não disse, e foi para fechar essa porta que eu refiz os dois recursos.
Uma chamada única virou agente com ferramentas em 6 de novembro
Em 6 de novembro, os dois recursos deixaram de ser uma chamada única ao modelo e viraram agentes com ferramentas. As ferramentas buscam nos documentos, leem um trecho, testam a fidelidade do texto e contam caracteres. O agente usa as ferramentas quando tem dúvida sobre o que pode afirmar.
Na avaliação, esse trabalho levou de 2 a 4 passos por texto. A escrita deixou de depender de uma única passada sobre o material enviado.
Depois do agente vêm duas travas em sequência. Primeiro entra um guarda em código, determinístico, que reprova o que não tem apoio nas fontes. Depois entra uma auditora, outro modelo em raciocínio alto, que confere o texto contra os documentos.
A mensagem perde a frase sem apoio e segue verdadeira
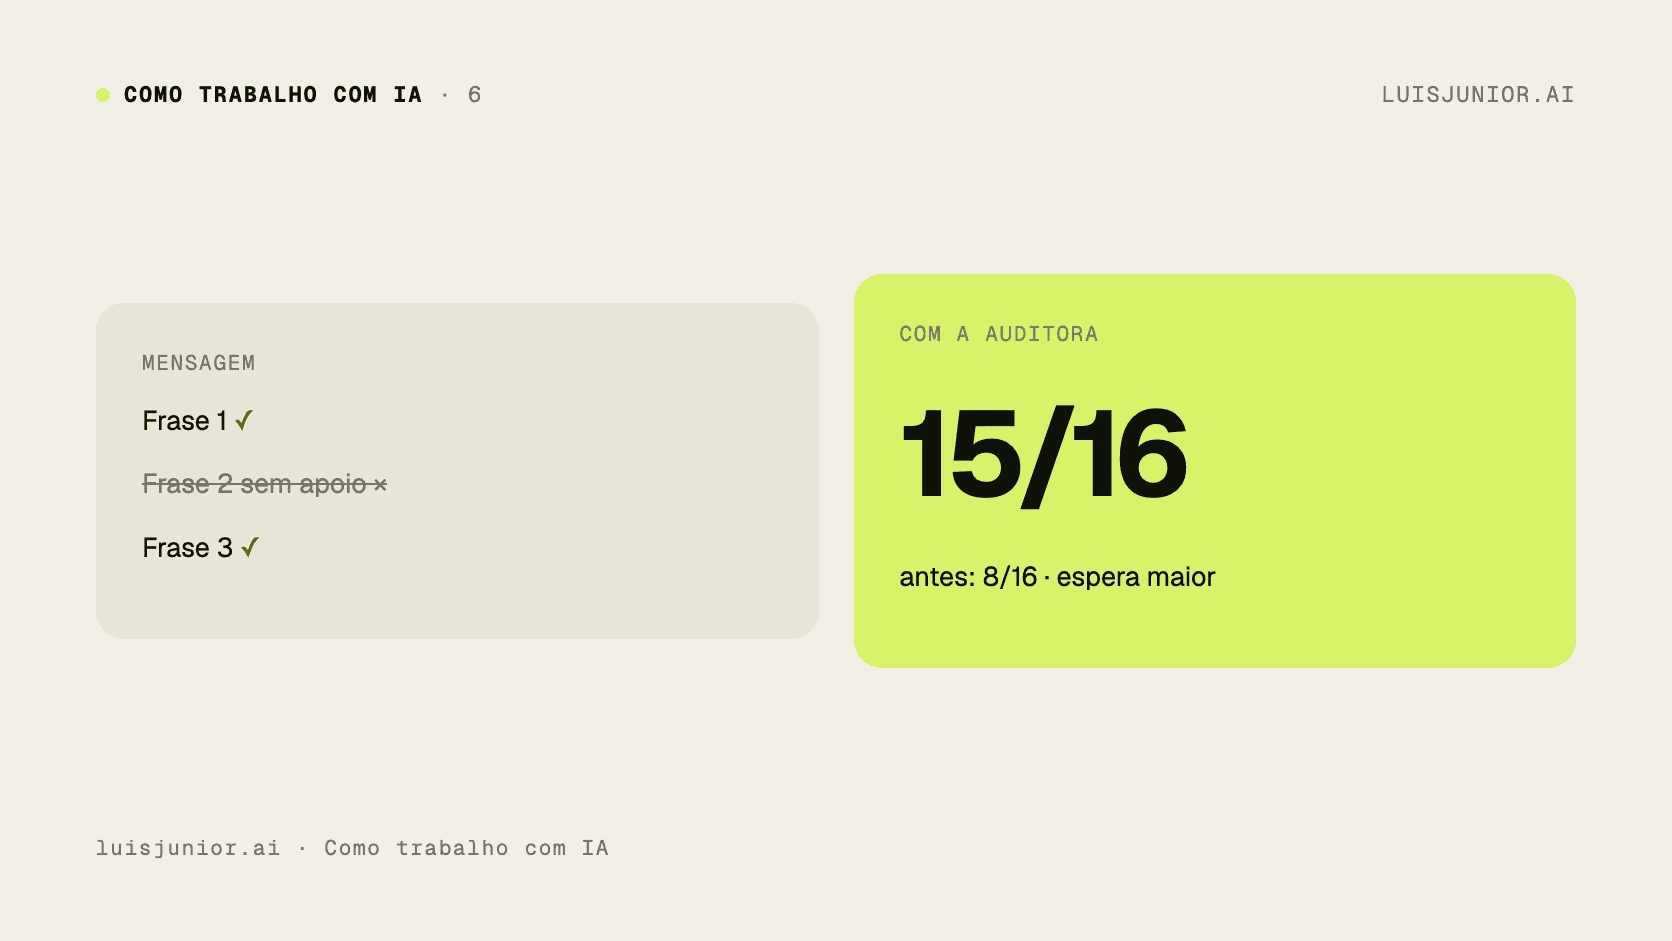
Na mensagem, o texto é cortado em frases e cada frase vai para uma auditora própria, com todas trabalhando ao mesmo tempo. A frase com um fato sem apoio sai da mensagem. Nada volta para o agente reescrever, porque uma nova escrita pediria outra auditoria com a pessoa esperando do outro lado.
A mensagem sem aquela frase continua verdadeira, e por isso ela pode seguir. Se só sobram a saudação e a assinatura, nenhuma mensagem aparece para o usuário. Nesse caso, a cota do mês também fica preservada.
Na resposta, a lógica muda porque o texto é uma afirmação só. Se a auditora reprova, a resposta não aparece e o usuário recebe o pedido para completar a informação: “Não consegui responder sem inventar. Me conte mais:”. Cortar metade de uma resposta mudaria o sentido do que restou, e por isso esse recurso prefere parar e perguntar.
A avaliação usa armadilhas antes de qualquer confiança
A avaliação roda com casos sintéticos montados para fazer o modelo inventar. As armadilhas pedem algo que os documentos não têm, como uma ferramenta, uma certificação ou um número. Na avaliação, havia uma pessoa esperando por vez.
Na mensagem, a chamada única passou em 8 de 16 casos, com tempo típico de 1,7 s e p95 de 2,2 s. O agente com as travas passou em 15 de 16 casos, com p50 de 19,5 s e p95 de 41 s. Ele cortou uma frase em 6 das 16 mensagens avaliadas.
Na resposta, a chamada única passou em 15 de 18 casos, com p50 de 1,6 s e p95 de 3,5 s, e entregou duas respostas enfeitadas com detalhe que os documentos não davam. O agente com as travas passou em 17 de 18 casos, com p50 de 2,9 s e p95 de 40 s. A resposta que termina pedindo um dado ao usuário sai em 1,3 a 3 s.
A espera cresceu junto com o acerto
O tempo é quase todo da auditora. O agente leva de 4 a 9 s, e cada auditora leva de 6 a 25 s. Baixar a auditora para raciocínio médio manteve a espera no mesmo nível, com p50 de 24,5 s, e derrubou o resultado para 13 de 16 casos na mensagem.
O juiz da avaliação é o mesmo modelo da auditora, e o veredito dele varia entre execuções, de 13 a 16 de 16 na mensagem. Por isso ainda não há linha de base fechada para comparar as próximas mudanças. A linha de base que eu aceito exige todos os casos aprovados, e esse critério continua valendo para as próximas rodadas.
O acerto subiu nos dois recursos e a espera subiu junto. Para um texto que fala em nome de alguém, prefiro a pessoa esperando alguns segundos a uma frase que ela nunca disse. O mesmo cuidado com o que a IA afirma aparece em a IA disse que usou as skills.