Desenvolvimento· Arrumando a casa · parte 18
Um PR do Dependabot travou meu banco e as rotas voltaram 500.
Veja como identifiquei conexões presas atrás do Hyperdrive e provei a correção antes de liberar uma atualização do driver.

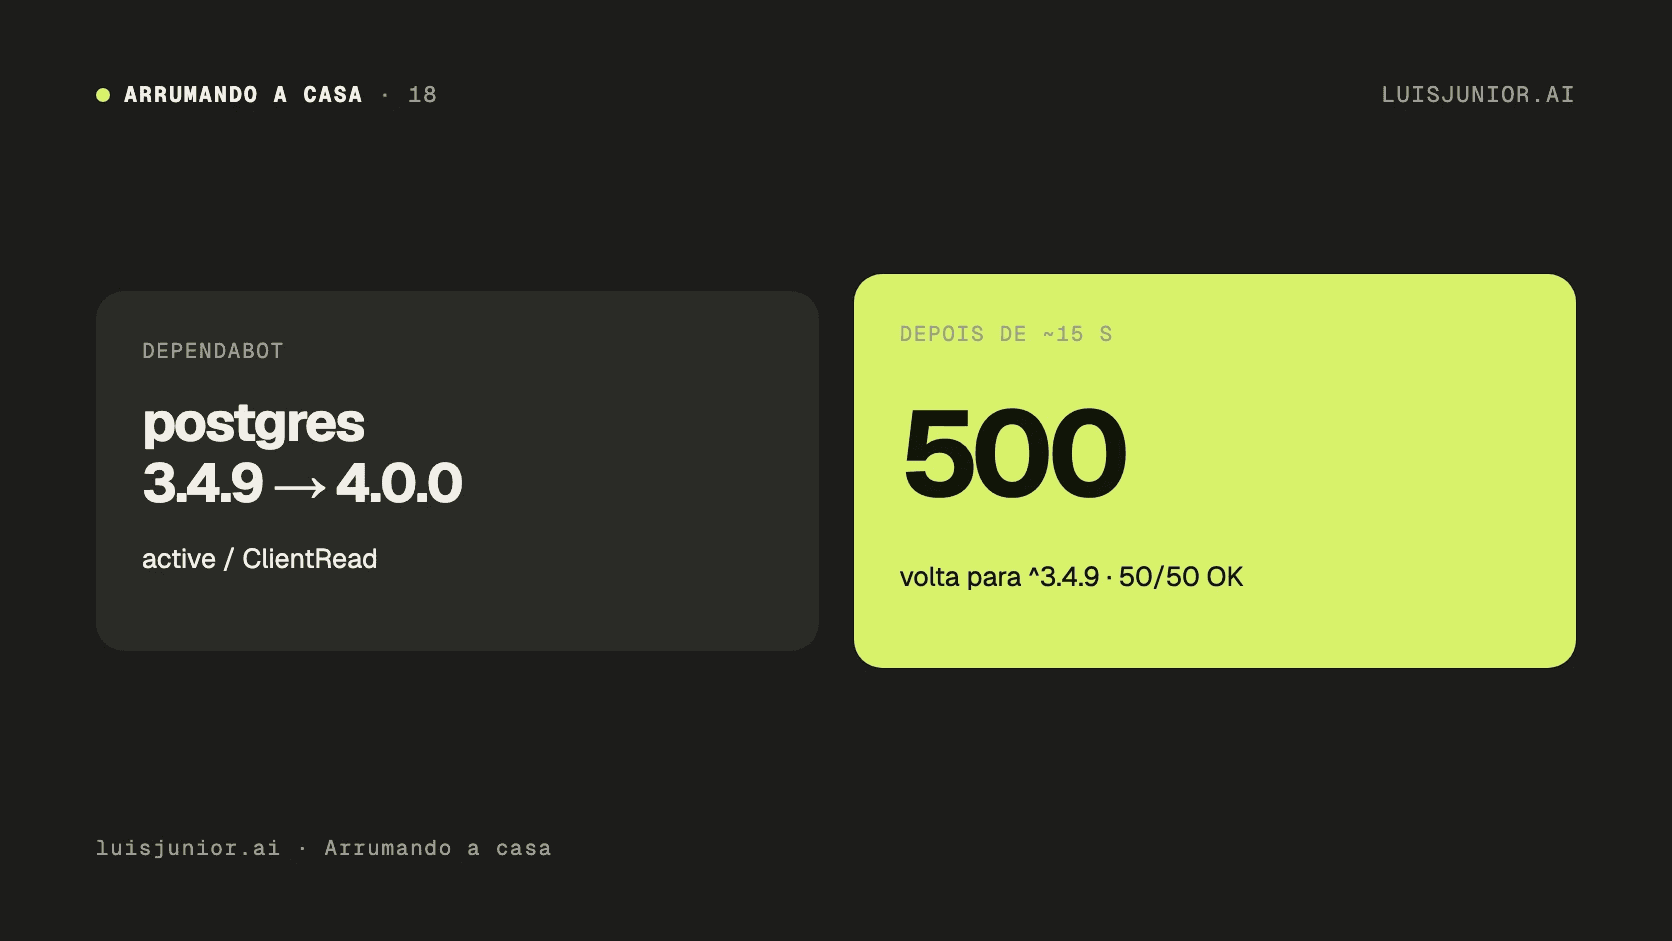
Uma atualização automática do driver de banco deixou conexões presas e fez rotas responderem 500. O pull request chegou pelo Dependabot, mas o teste que resolveu o caso precisou passar pelo Hyperdrive.
Meus produtos web usam a mesma base: Cloudflare Workers, Hyperdrive, PlanetScale Postgres e Better Auth. Um defeito num vale para os outros. Por isso, cada dependência compartilhada pede atenção redobrada.
A atualização chegou antes do sintoma
Em 4 de novembro, a versão 4.0.0 do driver postgres chegou a um produto que ainda não apresentei aqui por um pull request do Dependabot. A alteração envolvia uma mudança de versão maior do pacote usado para acessar o banco de dados.
Ela deixou conexões em active / ClientRead com transação aberta atrás do Hyperdrive e esgotou o pool. As rotas com banco passaram a responder 500 depois de uns 15 s, e as chamadas tRPC agrupadas travavam. O pool cheio impedia qualquer nova consulta de concluir.
A sequência dá um caminho claro de diagnóstico: conferir a alteração do driver e observar o estado das conexões no banco enquanto as requisições falham. Uma resposta 500 aponta para uma falha geral, mas não revela o estado interno do pool. Olhar diretamente para o banco permitiu associar o erro às conexões retidas.
Não investiguei a causa exata dentro do driver. O que ficou comprovado para a decisão foi o comportamento observado nessa combinação de ferramentas e o resultado prático após reverter a versão. Isso delimita a conclusão e define o critério para testes futuros.
O estado das conexões mostra o que procurar
Para ver conexões presas, a verificação em pg_stat_activity procura por state = 'active' com wait_event = 'ClientRead' há mais de um minuto. Essa consulta isola as conexões que permanecem ocupadas sem devolver o controle ao pool. Esse estado ajuda a confirmar se o problema está na retenção de processos pelo driver.
O detalhe da transação aberta também faz parte do diagnóstico. As conexões ativas permaneciam presas com transação em aberto, o pool se esgotava e as chamadas tRPC agrupadas travavam completamente. Acompanhar esses sinais juntos mostra o gargalo real de execução com precisão.
As chamadas tRPC agrupadas serviram para reproduzir o problema e validar a solução. Uma consulta isolada que responde com sucesso não demonstra que o pool suporta requisições simultâneas sem reter conexões. O teste precisava observar a conclusão das chamadas e a liberação imediata do banco.
Ao investigar um caso parecido, anote a versão do driver e a presença do Hyperdrive antes de comparar os resultados. A regra que adotei está ligada diretamente a essa combinação de infraestrutura. Alterar múltiplos fatores ao mesmo tempo impede saber qual modificação corrigiu o comportamento.
A volta de versão teve uma prova em staging
A correção foi voltar para ^3.4.9, a versão que o Garfim e outro produto usam. Também mandei o Dependabot ignorar a versão maior do pacote no arquivo de configuração. Assim, as próximas checagens automáticas não reabrem essa mesma versão maior até que o teste seja refeito.
A prova veio em staging: 50 de 50 consultas agrupadas com resposta 200 e nenhuma conexão presa. Nenhuma das consultas travou, e nenhuma conexão ficou presa no banco depois delas.
Esse resultado sustenta a decisão de manter a versão anterior estável. Ele não tenta adivinhar o mecanismo interno do driver. Qualquer atualização futura de versão maior precisará passar exatamente pelo mesmo roteiro de validação.
O registro mantém a prova completa: o cenário que travava e a confirmação em staging após o ajuste. Ter a contagem de respostas 200 junto com a verificação de conexões no banco dá a certeza de que a falha foi resolvida. O histórico evita repetir suposições em incidentes semelhantes.
A regra acompanha a stack comum
A regra que ficou para todos os meus produtos: não aceitar o postgres 4 sem repetir esse teste atrás do Hyperdrive. A atualização automática de dependências continua útil para acompanhar novidades. Uma versão maior de driver, porém, só entra depois de repetir as consultas agrupadas atrás do Hyperdrive e conferir o pool.
Registrei o caso numa lista de alertas da stack comum, com onde foi provado e o que conferir nos outros produtos. Compartilhar a mesma base permite antecipar problemas antes que eles cheguem aos usuários. Cada projeto com essa infraestrutura passa a ter o mesmo ponto de checagem documentado.
Uma dependência atualizada pode parecer inofensiva no pull request até derrubar as rotas que dependem do banco. O teste que prova a correção termina quando as consultas retornam com sucesso e o pool permanece livre. Também escrevi sobre outra decisão compartilhada entre produtos, a configuração do OpenRouter.