Desenvolvimento· Construindo o Garfim · parte 17
Como depurei um erro de API sem log no registro do Garfim.
O caso da API que falhava silenciosamente em voz e texto enquanto a foto funcionava, a mudança súbita no provedor e a lição de nunca esconder a causa no log.

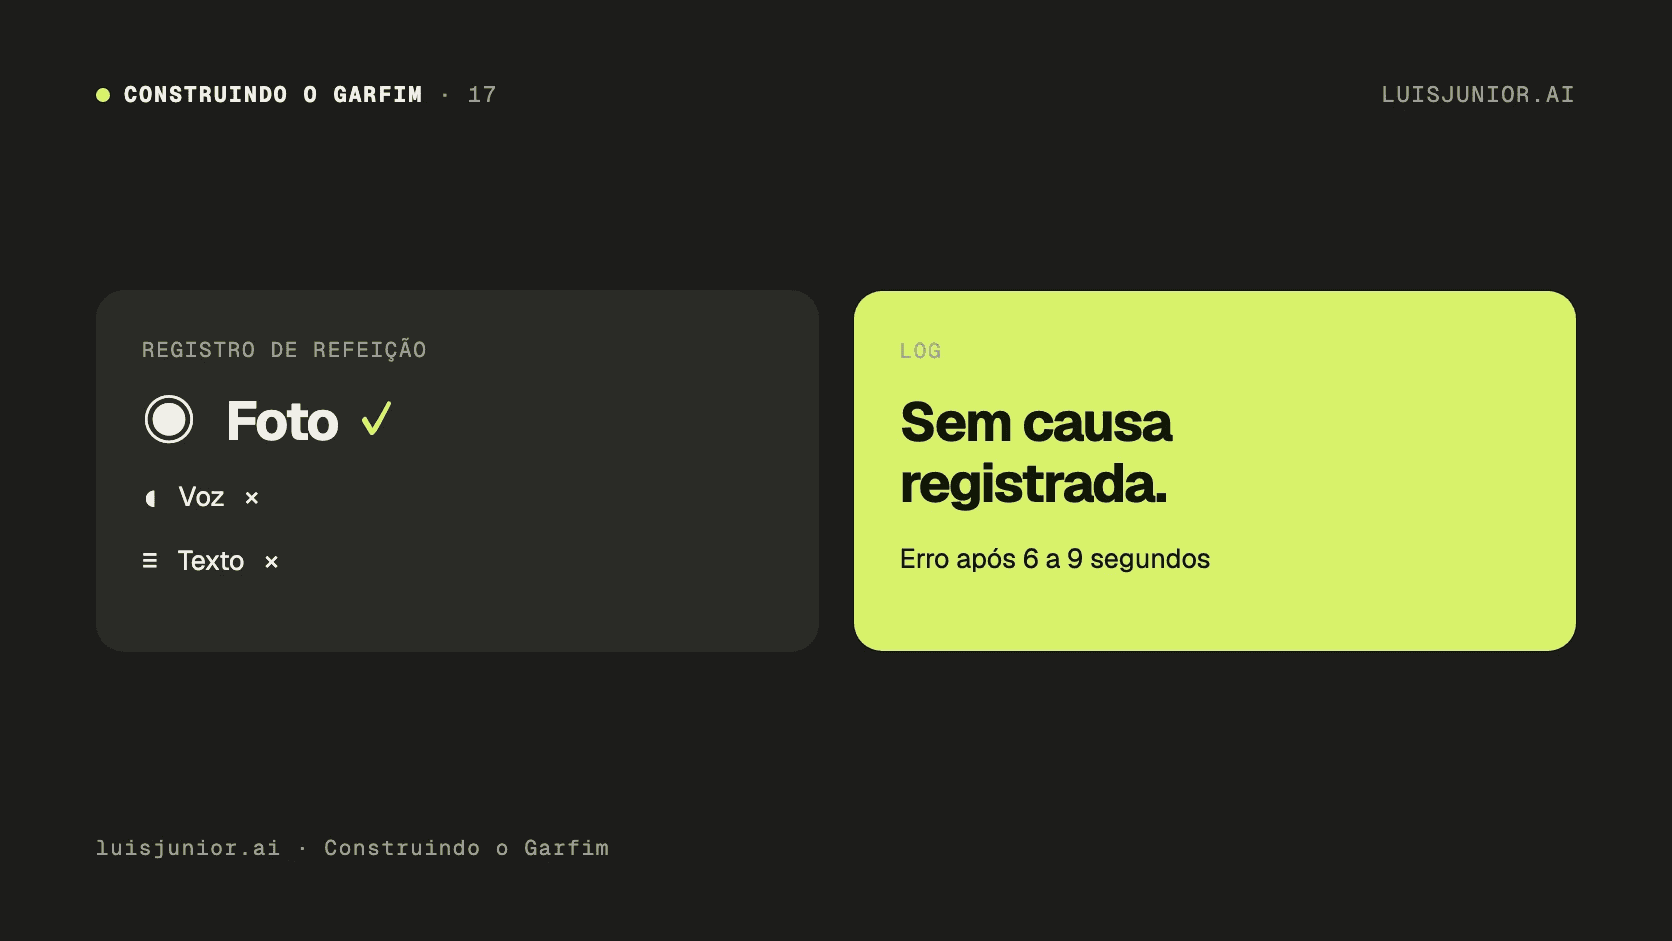
A foto funcionava no Garfim, mas voz e texto falhavam e o log não mostrava a causa. O registro por foto retornava resultados, mas tentativas de registrar refeições por áudio ou digitação retornavam erro entre 6 e 9 segundos após o envio. No dia anterior, em 29 de outubro de 2026, uma refeição por voz havia sido salva em produção.
Ao abrir o terminal para examinar os registros do servidor, o painel estava limpo. Não havia registro de exceção, rastreamento de pilha ou qualquer aviso de falha. A API respondia com código HTTP 503 e entregava uma mensagem amigável no celular, mas a causa técnica permanecia invisível.
A investigação desse caso mostrou na prática como o cuidado excessivo em tratar mensagens de erro pode cegar a engenharia. Quando um sistema esconde a origem técnica de uma falha para proteger a interface, ele impede que você descubra o que realmente quebrou.
O registro por foto funcionava enquanto voz e texto falhavam
O comportamento do sistema parecia contraditório à primeira vista. A análise de imagens depende de modelos visuais complexos e continuava retornando resultados. Já as rotas de texto e voz, que teoricamente executavam tarefas mais leves, falhavam de forma sistemática.
O fluxo de voz passa pela rota de processamento de texto. Ambas as entradas precisam extrair os nomes dos alimentos descritos e pesquisar os itens correspondentes na base nutricional por meio de comparação vetorial.
Quando a requisição encerrava com erro 503, o aplicativo exibia um código amigável de falha de reconhecimento. Para quem utilizava o produto no celular, a sensação era de uma instabilidade passageira de conexão. Nos bastidores, porém, nenhuma refeição falada ou digitada conseguia ultrapassar a etapa de processamento.
O erro amigável na tela escondia a falha real nos servidores
A ausência de informações no log aconteceu por causa de uma decisão arquitetural da API. As falhas retornadas pelos provedores de inteligência artificial eram capturadas por blocos de tratamento e convertidas diretamente em códigos internos de retorno do aplicativo.
Como o framework de rotas só registrava automaticamente falhas graves não tratadas do servidor, respostas tratadas eram consideradas desfechos esperados do negócio. A falha tratada não gerava uma linha que mostrasse sua causa.
O primeiro passo para resolver o mistério foi instrumentar a captura da causa real. Adicionei um registro estruturado de falha de reconhecimento que permitiu identificar o erro de embedding e a latência da requisição. Imediatamente após a publicação desse ajuste em homologação, o terminal começou a falar: a chamada ao modelo de embedding da Google falhava após apenas 58 milissegundos.
O log estruturado revelou a mudança repentina no provedor
O registro inicial comprovou que a etapa de extração dos nomes dos alimentos ocorria com sucesso. O problema real acontecia na etapa seguinte, quando a API tentava transformar esses nomes em vetores para buscar alimentos equivalentes no banco.
Para aprofundar o diagnóstico, alterei o cliente de integração para reter o status HTTP original devolvido pelo provedor intermediário. Ao enviar uma frase de teste com dois alimentos, o log exibiu com clareza um erro de resposta com código HTTP 404 após 47 milissegundos. Ao testar uma frase com um único alimento, a resposta retornava normal.
A causa raiz estava desvendada: em 30 de outubro de 2026, o OpenRouter respondia 404 para requisições de embeddings contendo múltiplos textos sob as restrições de provedor e retenção zero usadas pelo Garfim, sem sequer encaminhar a solicitação para a Google. Como a análise por foto pesquisava cada alimento detectado individualmente, ela permaneceu imune. Já o texto agrupava todos os termos da frase em uma única chamada. Nenhuma linha de código do Garfim havia mudado: tratava-se de uma alteração silenciosa de comportamento no provedor externo.
A correção em paralelo e o teste de regressão restabeleceram o fluxo
Identificada a origem, a correção exigiu mudar a estratégia de envio das requisições. O cliente de embeddings foi reescrito para enviar estritamente um único texto por chamada, disparando até seis requisições simultâneas para respeitar a cota de conexões concorrentes da infraestrutura de Workers.
Para detectar a regressão, escrevi um teste na camada de adaptadores. Esse teste reproduz exatamente o comportamento da falha: simula o erro 404 diante de requisições com múltiplos textos e valida a geração do vetor quando os textos descem em chamadas individuais. Se esse teste for executado contra o código anterior, ele falha imediatamente.
Após a execução bem-sucedida de todas as suítes de teste de integração e tipagem, o pacote foi publicado em homologação e em produção. O teste real com a frase clássica “comi arroz e feijão” voltou a responder código HTTP 200 de imediato, combinando os dois itens com os alimentos da base sem gerar novas ocorrências de falha.
Tratar o erro para o usuário exige preservar a causa técnica
A grande lição desse incidente reside na separação entre experiência do usuário e visibilidade operacional. Entregar uma mensagem limpa e compreensiva na tela do celular é obrigação de qualquer bom produto, mas proteger a interface não autoriza silenciar a engenharia.
Quando uma exceção de terceiro é engolida para gerar uma resposta bonita, o sistema transforma um defeito de infraestrutura em uma incógnita. Sem um log estruturado que preserve a causa original e o código de retorno, a depuração depende de adivinhação.
Manter a causa diagnosticável nos registros do servidor dá um ponto de partida para investigar falhas de provedores. Para entender como integro essa governança com o bloqueio seguro de versões em caso de incidentes graves, leia sobre como forçar atualização no React Native.